Documentació clínica escrita
per la veu del professional
El meu Treball de Fi de Grau: un mòdul d'intel·ligència artificial per a Streamly, la plataforma de gestió clínica on treballo. El professional parla durant la visita i el sistema li retorna la fitxa clínica emplenada, a punt per revisar.
- Treball Final de Grau
- UPC · Manresa
- Titulació
- Enginyeria de Sistemes TIC
- Memòria
- UPCommons ↗
- Producte
- Streamly ↗
Una visita sencera, de principi a fi
Enregistrament complet de la defensa: des de l'activació del mòdul fins a la fitxa clínica desada a la visita del pacient.
L'origen
Un problema que no em vaig inventar
Vaig entrar a Streamly fent pràctiques, i el TFG va arribar en el moment just. Els usuaris repetien una queixa: emplenar la fitxa de cada visita costa temps, i aquest temps el treus al pacient.
Alhora, l'empresa volia posar intel·ligència artificial al producte, però no com un adorn. Volia que servís per a alguna cosa concreta. Ajuntar les dues coses va donar forma al projecte.
No era un exercici de classe: era un problema real, amb usuaris reals a l'altra banda.
Van ser gairebé sis mesos, de febrer a juliol de 2026: analitzar el problema, construir el motor de transcripció, connectar el model de llenguatge, desplegar-lo al núvol i, al final, explicar-ho tot en una memòria de cent pàgines.
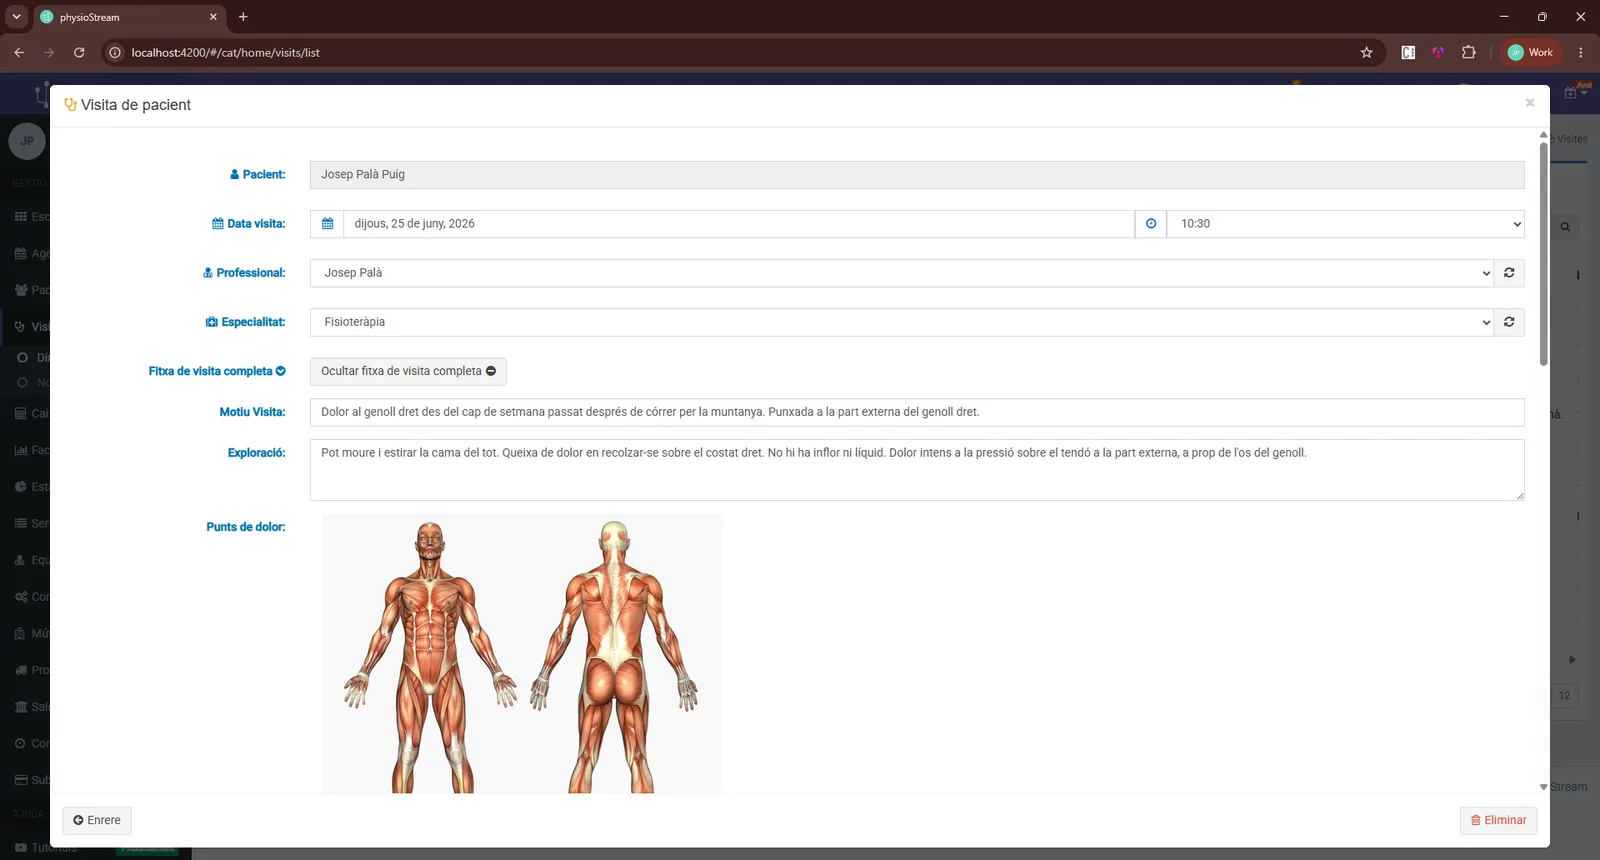
El que passava a la consulta era això: durant la sessió, gairebé tots els professionals només apunten el motiu de la visita o la marquen com a feta. El diagnòstic, el pla i l'evolució queden per després, en l'estona entre pacient i pacient i tirant de memòria. El resultat: històries clíniques incompletes.
Tres decisions, i totes les pren el professional
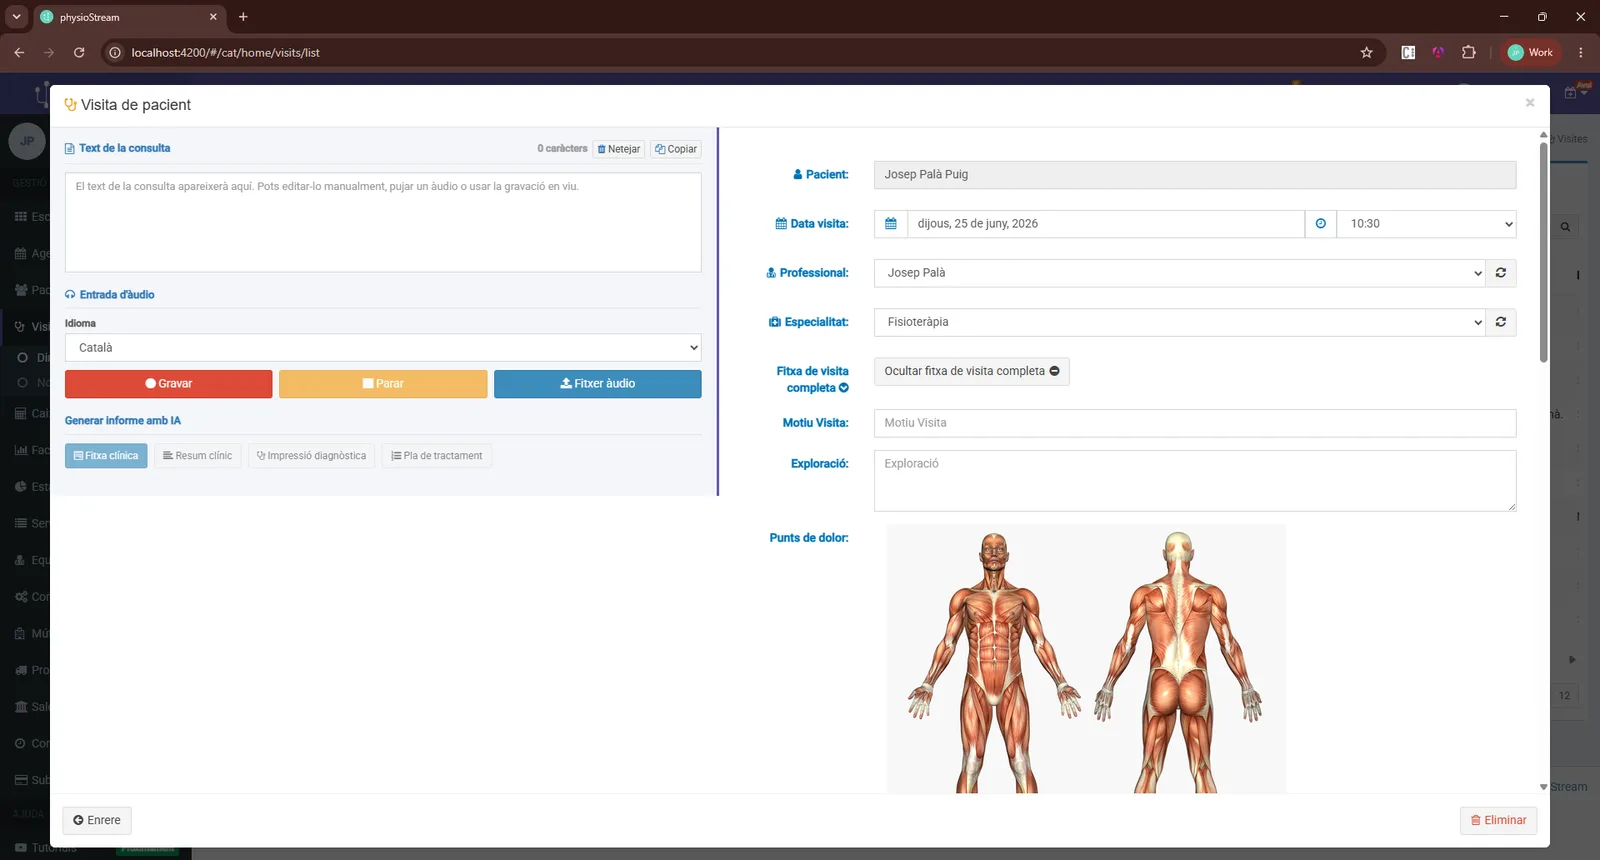
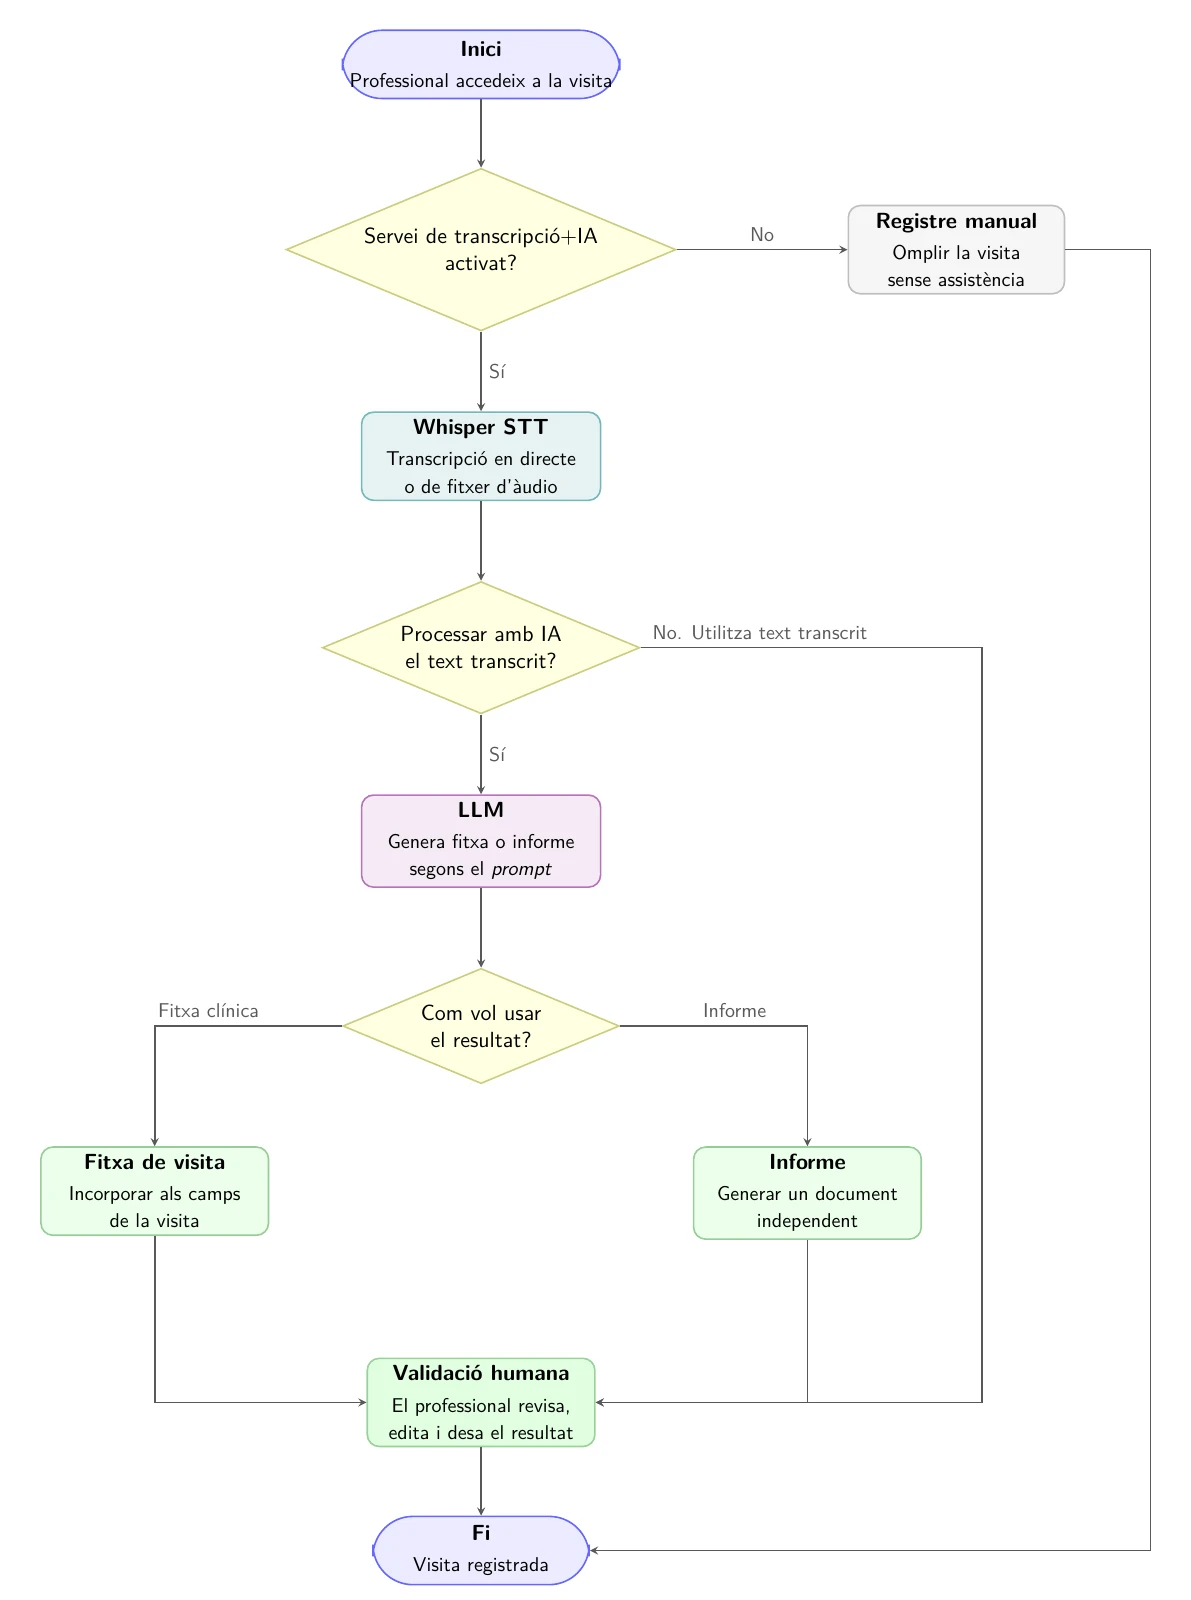
El vaig dissenyar perquè la IA no faci mai res pel seu compte. El professional activa el mòdul, decideix si vol passar el text pel model de llenguatge i, passi el que passi, revisa el resultat abans de desar-lo. Si el mòdul està apagat, la visita s'emplena a mà, com sempre.
Què passa entre la veu i la fitxa
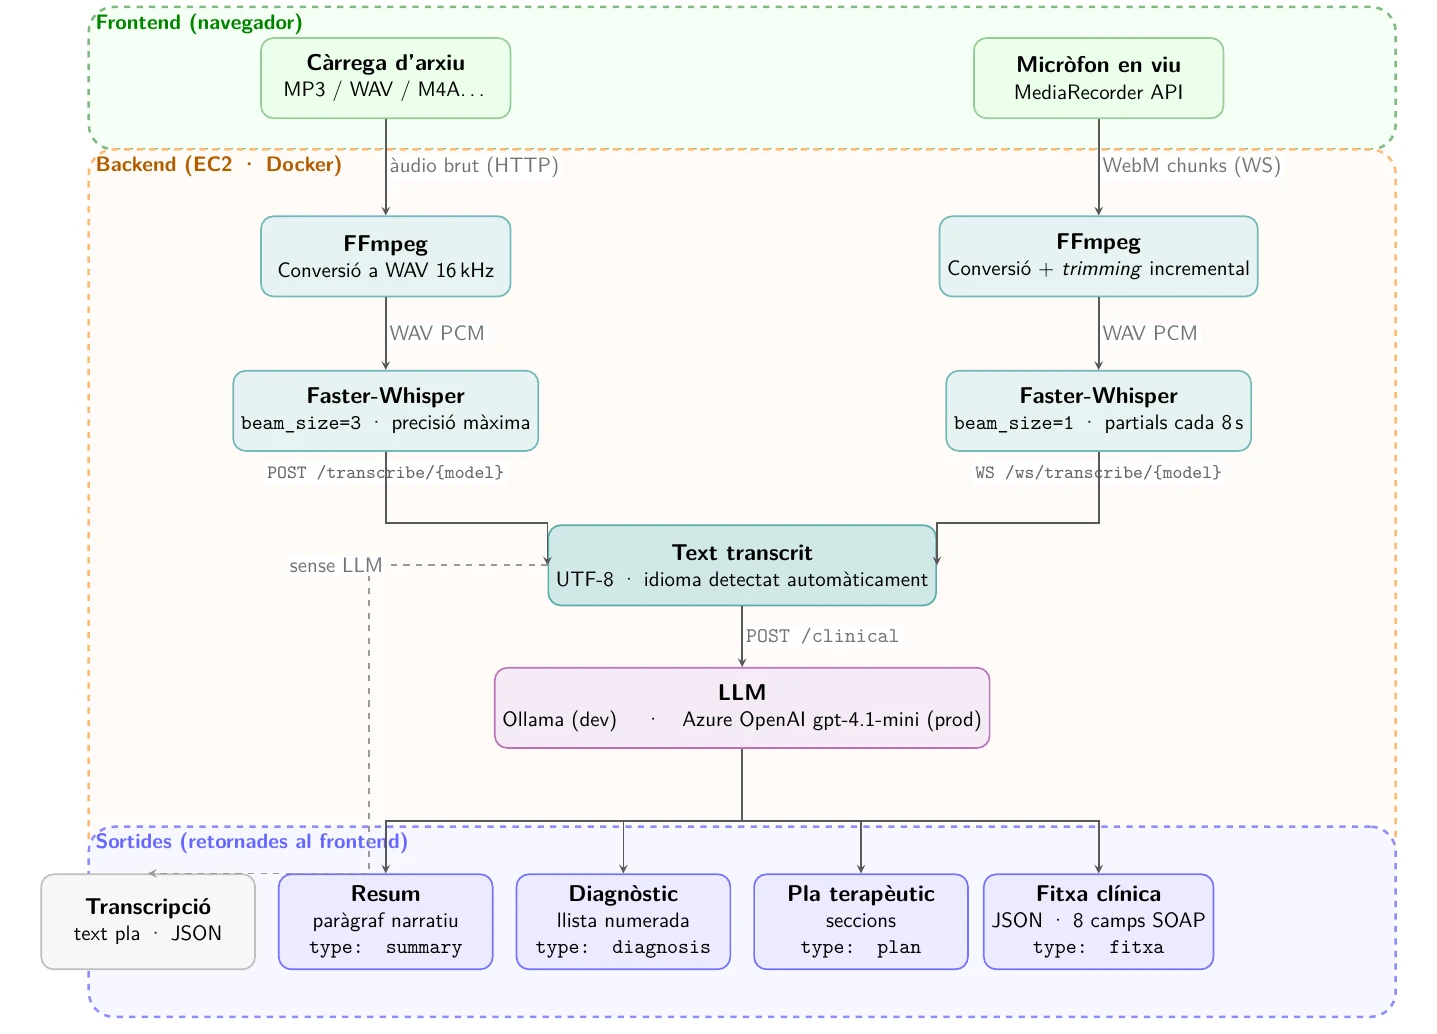
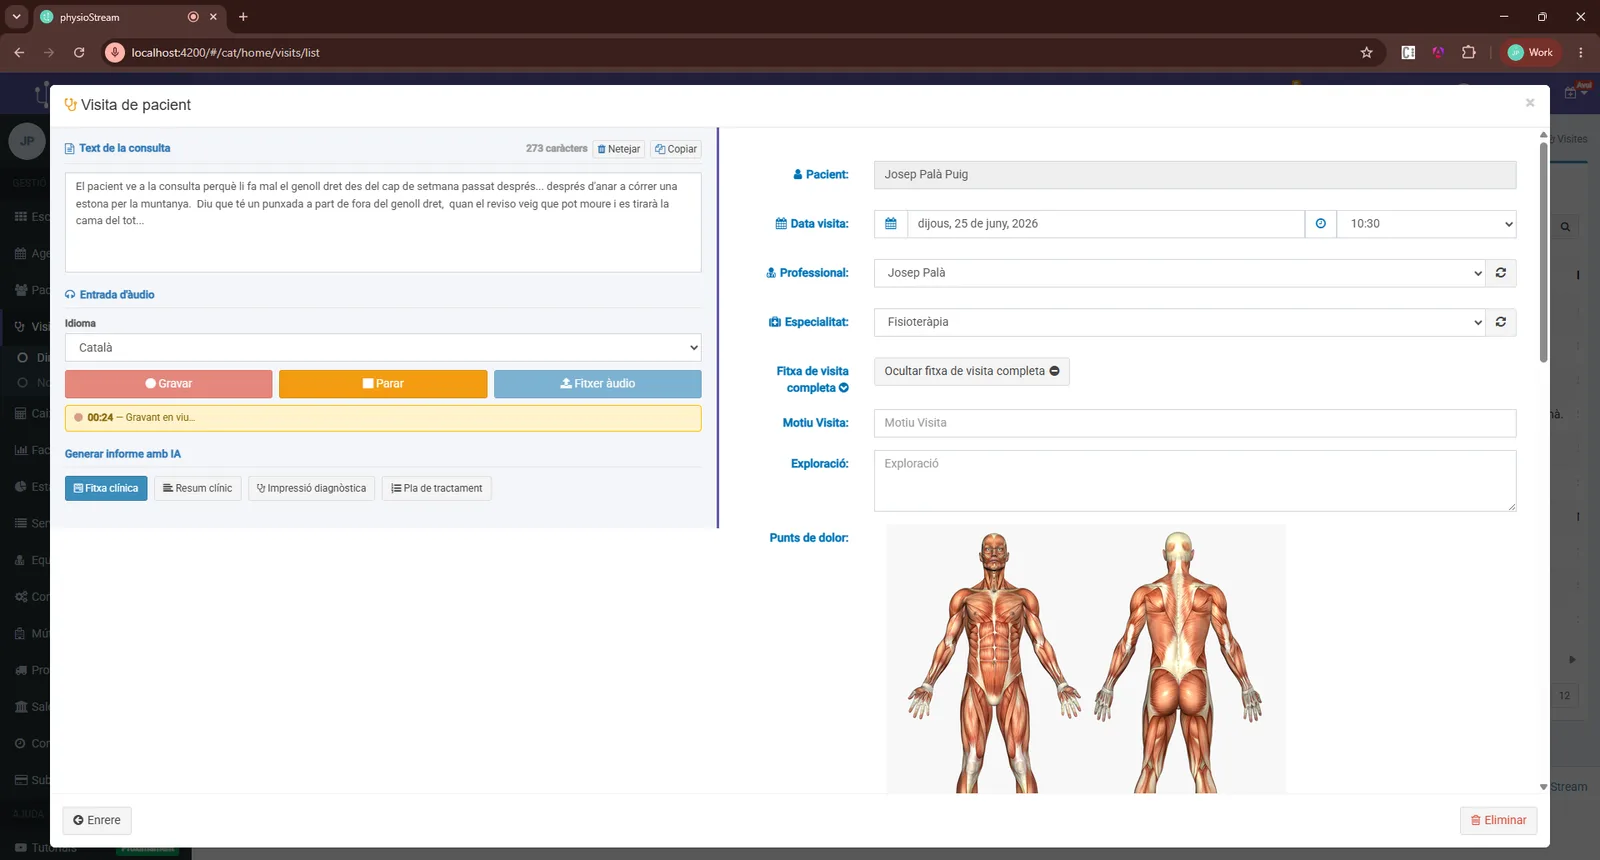
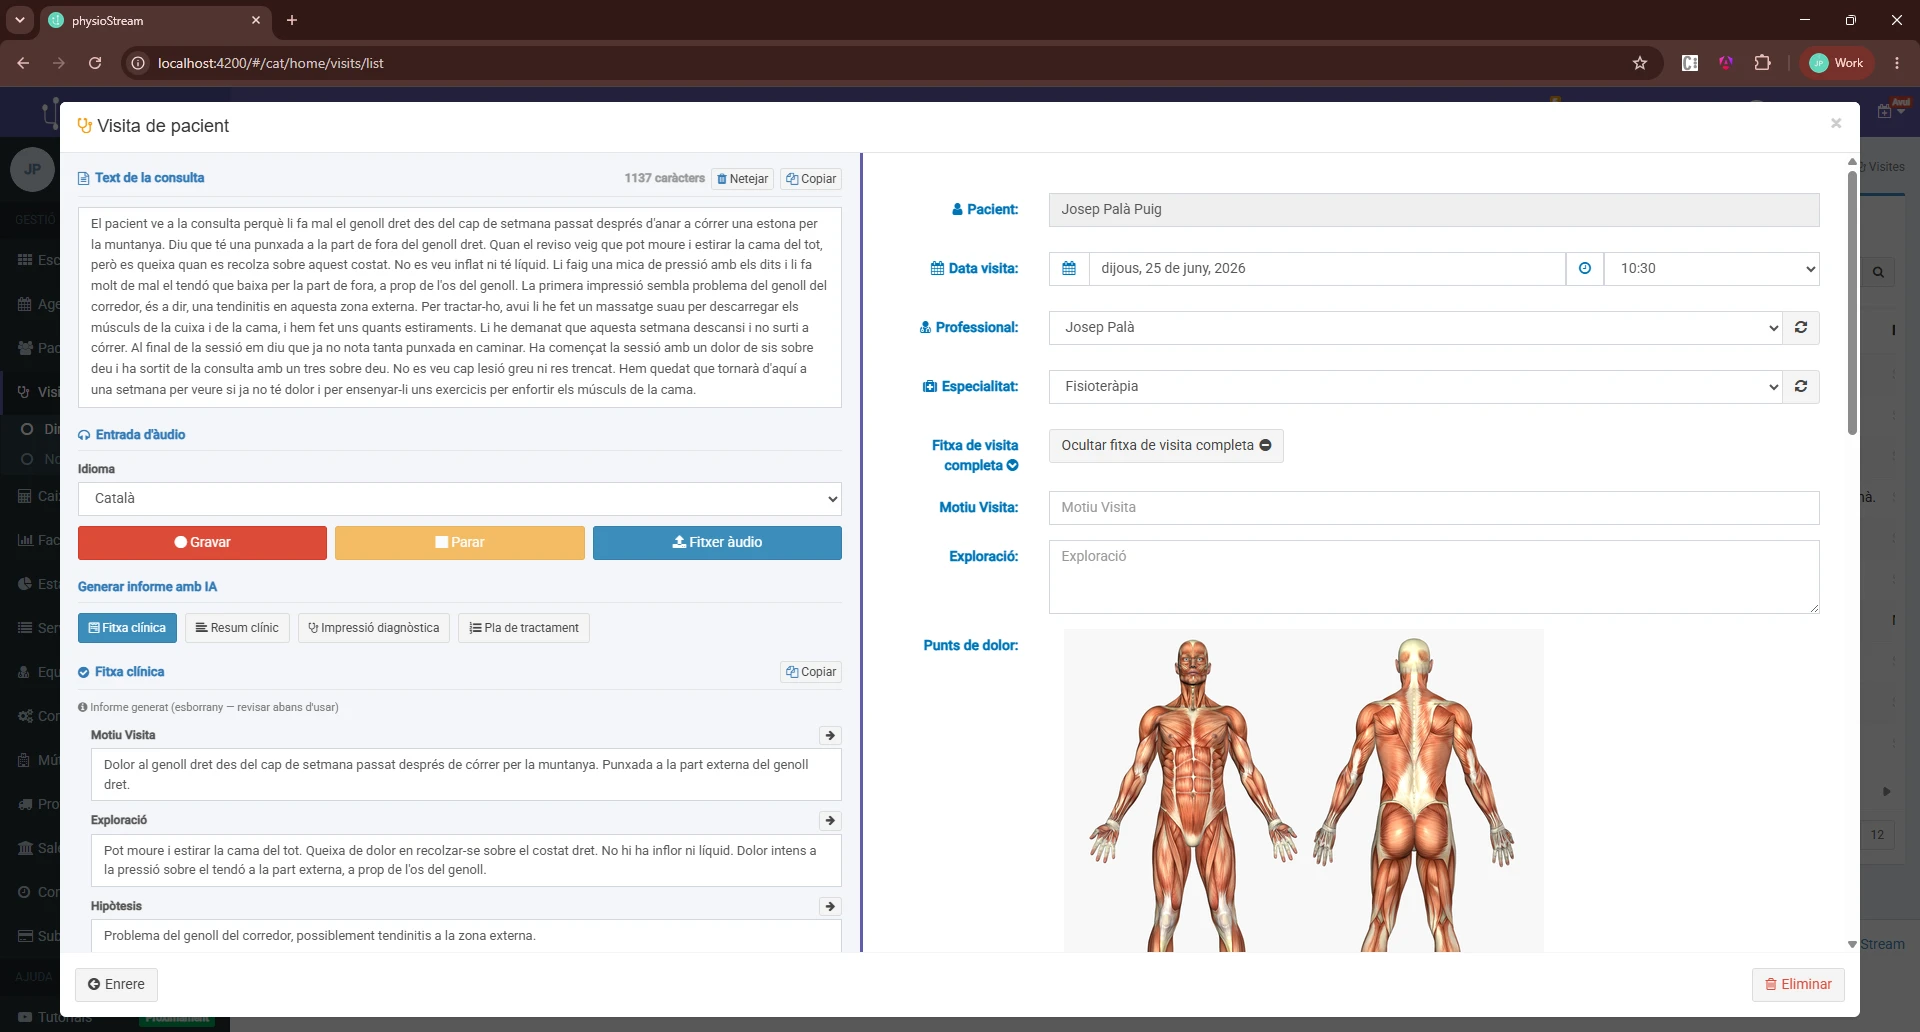
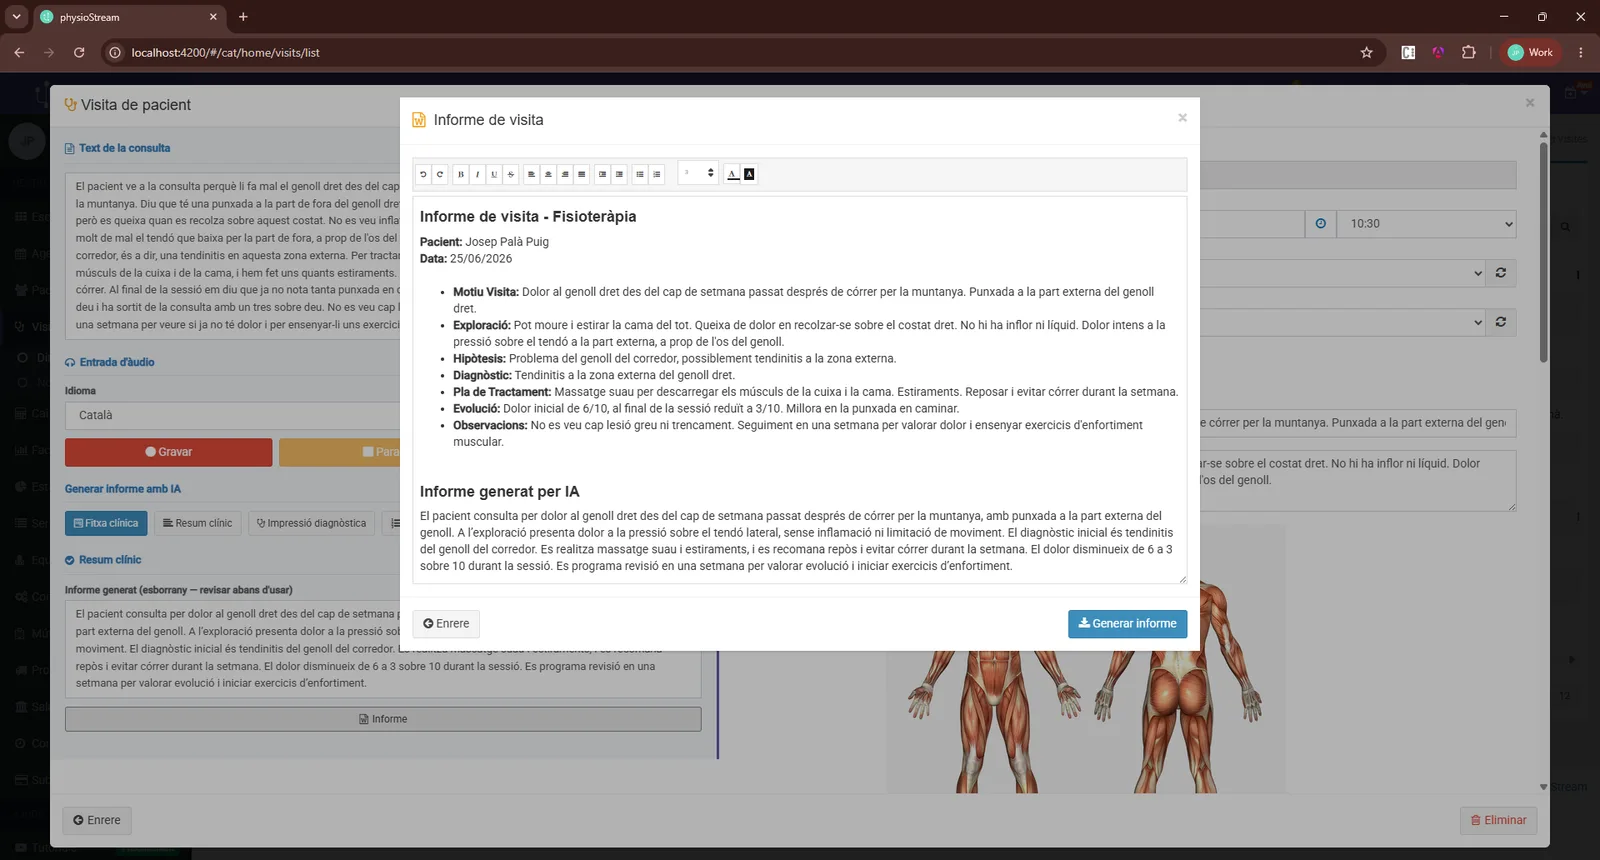
L'àudio entra per dos camins: un fitxer ja gravat o el micròfon, en directe. Tots dos acaben al mateix text transcrit, i aquí el professional tria: quedar-se la transcripció tal qual o demanar al model de llenguatge una de les quatre sortides: resum, diagnòstic, pla terapèutic o fitxa clínica.
Els detalls que no es veuen
- Transcriure mentre parles
- En directe, el navegador envia l'àudio a trossos per WebSocket i el servidor transcriu el que és nou cada vuit segons. Així el text va apareixent mentre el professional parla, no quan acaba.
- Paraules tallades per la meitat
- Provant-lo vaig veure que de vegades es perdia una síl·laba just al tall entre dos trossos. La solució va ser solapar mig segon cada finestra amb l'anterior. No va sortir de cap teoria: va sortir de fer-lo servir.
- Un àudio que no sap quant dura
- El format que grava el navegador (WebM) no desa la durada fins que s'acaba la gravació. Per saber quants segons portava acumulats, el servidor converteix l'àudio i el mesura amb FFmpeg cada vegada.
- La connexió que es tancava abans d'hora
- De vegades el canal es tancava abans que arribés la transcripció final. Vaig afegir un control perquè el navegador esperi aquesta última resposta. Ho vaig validar amb més de cinquanta gravacions i menys d'un 5 % d'errors.
Cada centre té la seva pròpia fitxa
Un fisioterapeuta i un podòleg no apunten el mateix. Per això la fitxa no està escrita al codi: els camps arriben des de la configuració de cada centre a Streamly, i amb ells es construeix la instrucció que rep el model. Si un centre afegeix un camp, la fitxa l'inclou sense tocar res.
Totes les instruccions porten la mateixa regla: treure només el que es diu a la transcripció, sense inventar res. Si un camp no es menciona, es queda buit. I la temperatura del model és baixa (0,3) perquè s'arrapi al text i no es posi creatiu.
Quin model entén millor el català mèdic
Per decidir-ho vaig preparar vint àudios de veu real d'un minut, deu en català i deu en castellà. Cadascun llegeix un text clínic escrit expressament amb les paraules on aquests models solen fallar: termes com cervicàlgia o gonartrosi, referències anatòmiques i noms de pacient. La mesura és el WER (taxa d'error per paraula): de cada cent paraules, quantes surten malament.
El model del Barcelona Supercomputing Center passa d'una paraula errònia de cada tres a una de cada vuit. En vuit dels deu àudios catalans, l'error d'AINA és un terç o menys. Per al castellà no calia: whisper-small ja hi obté un 13,53 %, així que el model especialitzat només s'aplica al català.
Un dels vint àudios, el ca_04, donava un error superior al 100 %. Semblava un error de mesura, però no ho era: en arribar a un tram final amb poca veu, el model entrava en bucle i s'inventava text que no era a l'àudio.
D'aquí surten dues decisions. La xifra que es publica és la mediana, perquè aquest sol cas empenyia la mitjana fins al 18,78 %. I la revisió del professional va quedar com a pas obligatori: cap sistema de transcripció automàtica està lliure de fallar en un cas concret, per bo que sigui el seu error mitjà.
Per què el sistema necessita GPU
AINA és més precís, però també molt més pesat. La diferència entre processar-lo amb el processador normal o amb una targeta gràfica decideix si el sistema es pot fer servir durant la consulta o no.
1,68s
AINA amb GPU
Tesla T4. Prou ràpid per transcriure mentre dura la visita.
46,46s
AINA amb CPU
Vint-i-nou vegades més lent. Inviable amb el pacient al davant.
1,43s
Fitxa clínica · núvol
Mitjana de les quatre sortides amb Azure OpenAI en producció.
20,32s
Fitxa clínica · local
El model local en desenvolupament: catorze vegades més lent.
Del portàtil al núvol
La primera versió funcionava sencera al meu portàtil: el servidor, la transcripció, un model de llenguatge local i una capa per anonimitzar el text. Funcionava, però era lenta i no es podia ensenyar a ningú. La versió final viu en un servidor amb GPU a AWS, empaquetada en Docker, i només el text surt cap a Azure OpenAI per generar la fitxa.
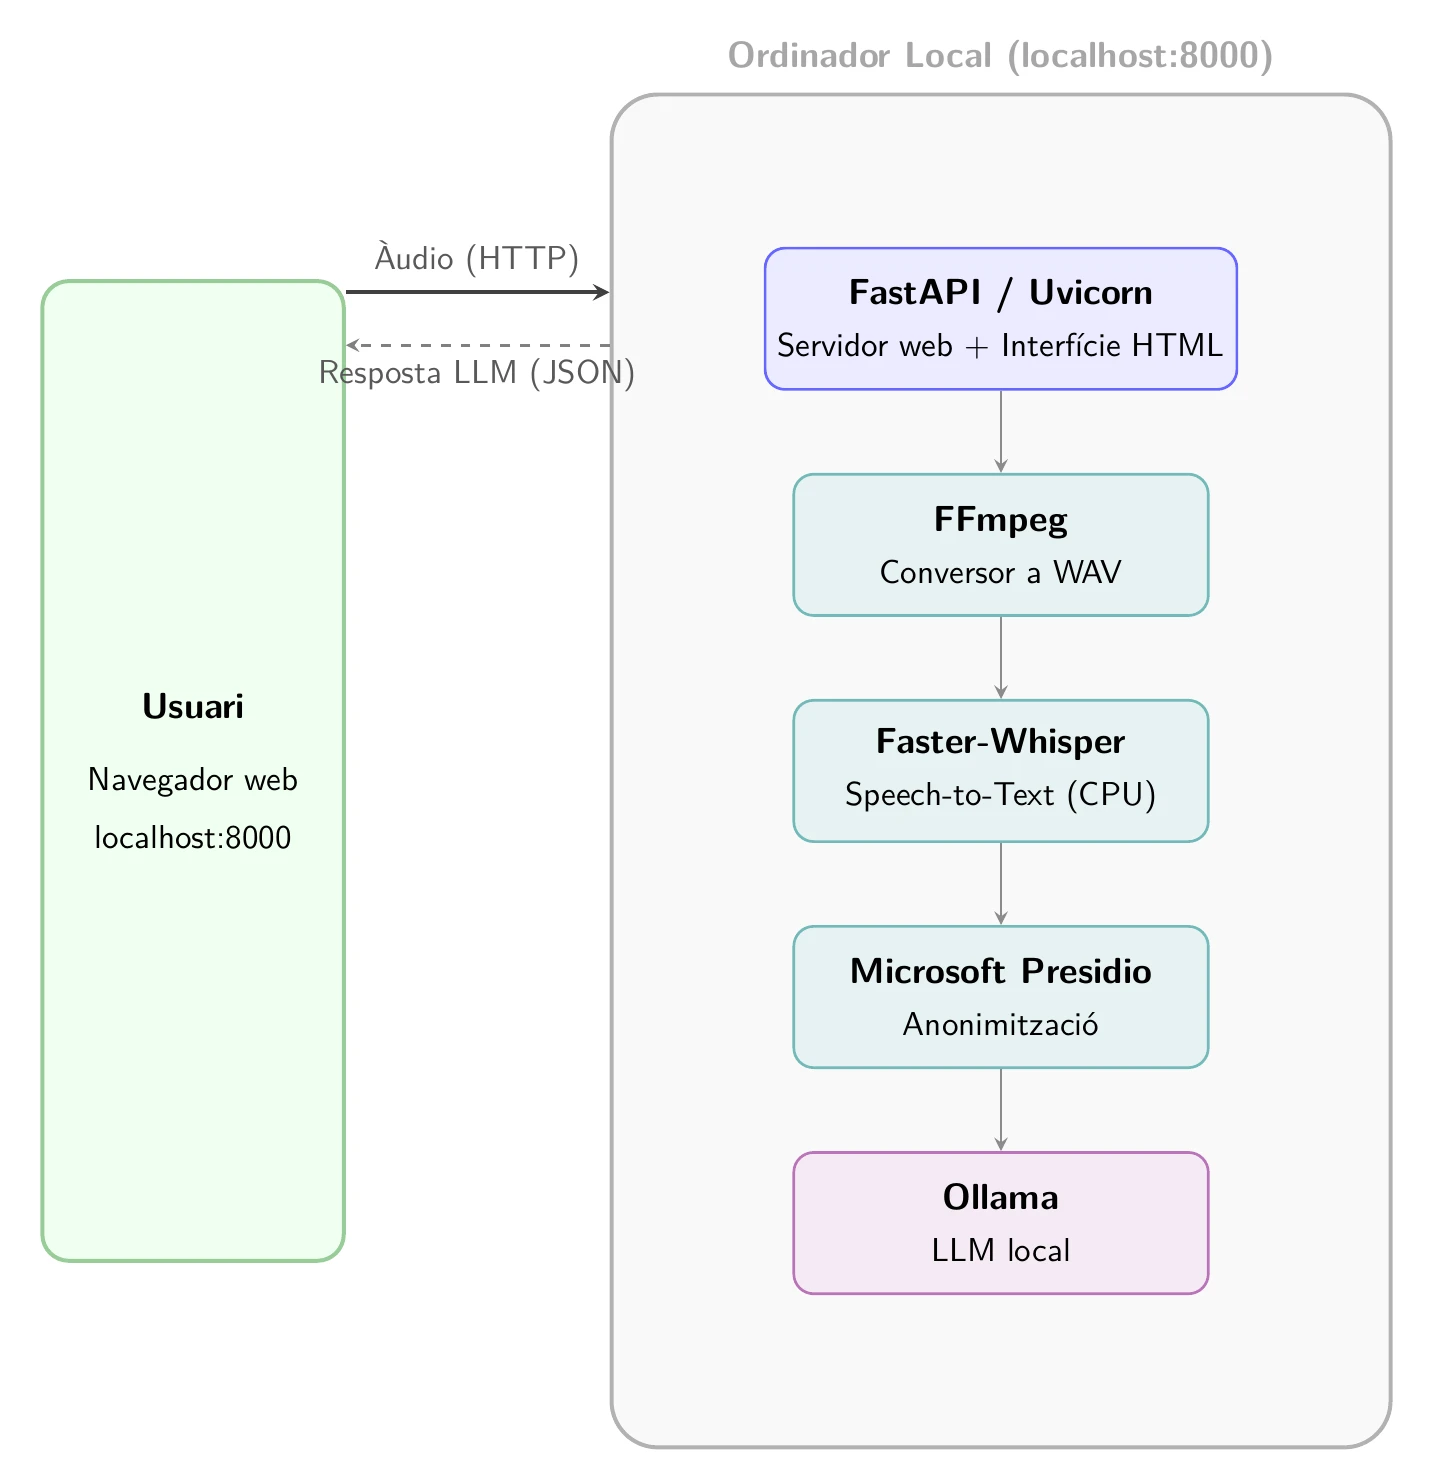
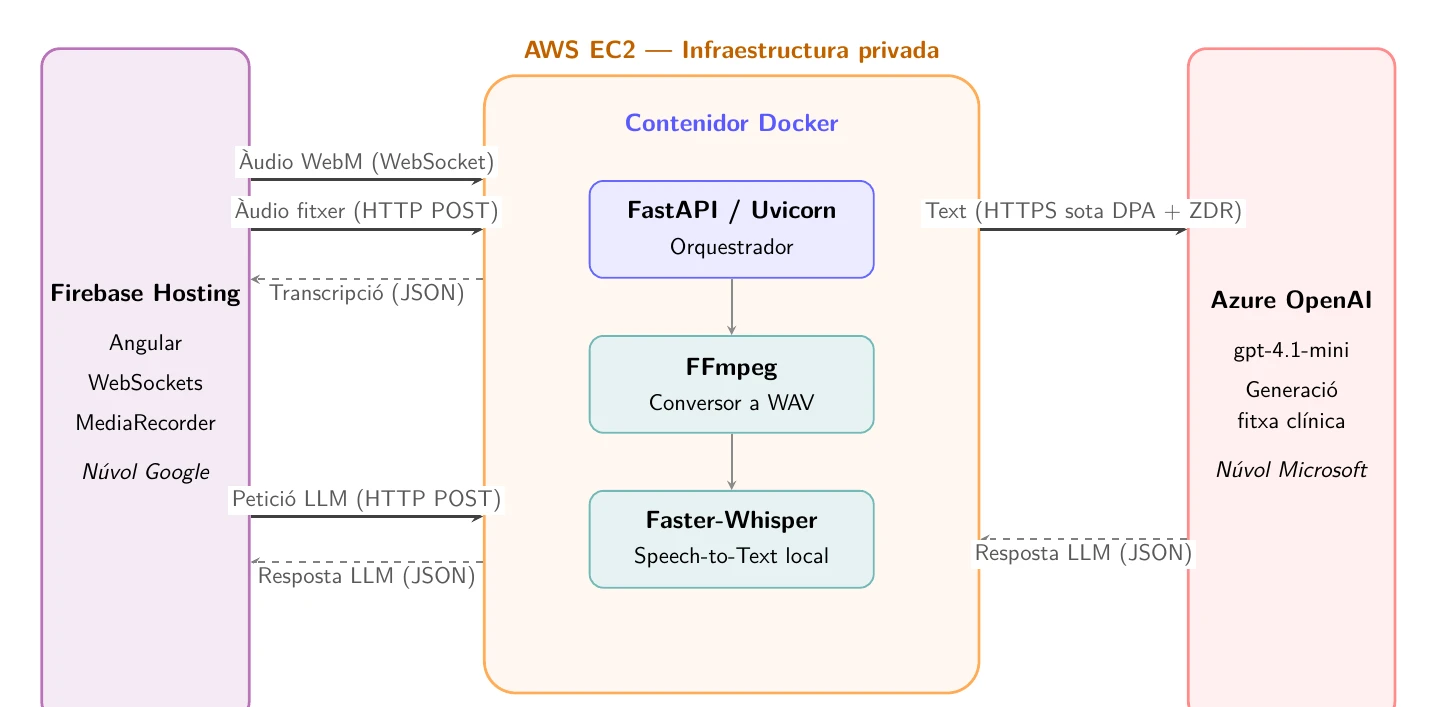
Una de les decisions que més em va ensenyar va ser treure una cosa que ja funcionava: la capa d'anonimització.
Sobre el paper era bona idea: abans d'enviar el text al model, Microsoft Presidio buscava noms, telèfons o DNI i els substituïa. Però amb textos clínics en català fallava pels dos costats. Marcava com a dades personals paraules com pàdel o drenatge i, en canvi, deixava passar noms i cognoms reals. Espatllava el text que rebia el model i, a sobre, donava una falsa sensació de seguretat. Una protecció que funciona a mitges pot ser pitjor que no tenir-ne, així que la vaig treure i vaig canviar l'enfocament: l'àudio no surt mai de la infraestructura, i el text viatja amb garanties contractuals.
La veu no surt de la infraestructura
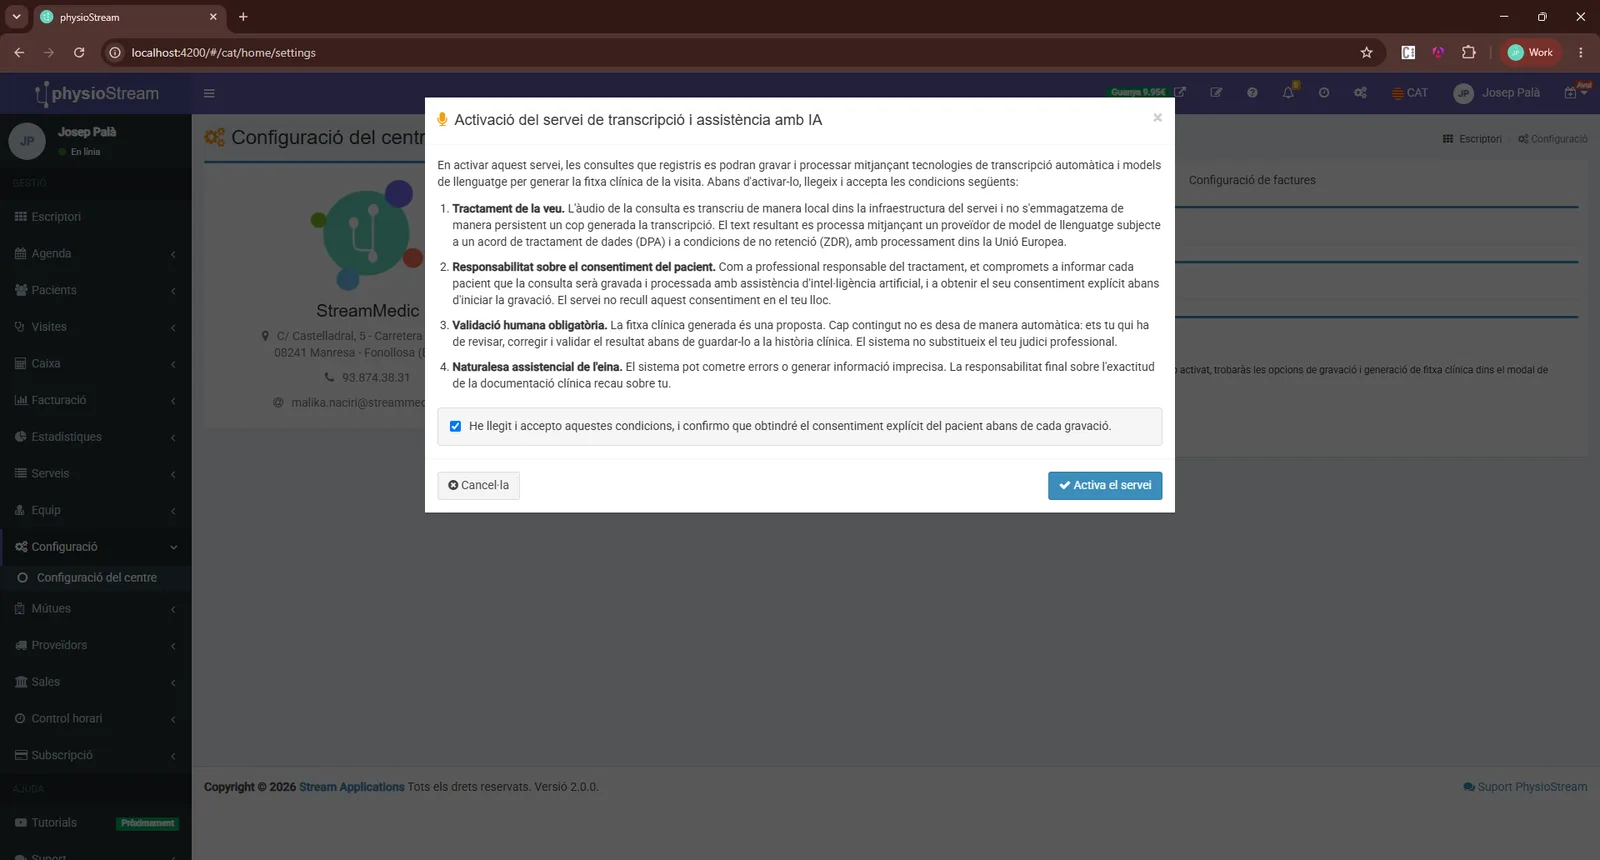
El RGPD classifica les dades de salut com a categoria especial, el règim més estricte. Això condiciona l'arquitectura abans que cap decisió de model: la transcripció s'executa sempre dins la infraestructura controlada i l'àudio no viatja mai a cap tercer.
- Àudio Sempre local
- Faster-Whisper corre dins la mateixa màquina que rep l'enregistrament. El fitxer d'àudio no surt en cap moment de la infraestructura del projecte.
- Text Marc contractual
- Només el text transcrit arriba al model de llenguatge, en una regió europea. L'arquitectura està pensada per anar amb contracte d'encarregat del tractament i sense retenció de dades per part del proveïdor; signar aquest contracte és un dels passos pendents abans de fer-lo servir amb pacients reals.
Què costa i què estalvia
La transcripció no té cost variable, perquè s'executa a la màquina pròpia. El que pesa és la instància amb GPU, que és fixa.
476€/mes
Cost operatiu
Instància amb GPU i model de llenguatge, en un escenari de mil consultes diàries.
330–920€/mes
Estalvi estimat
Per professional, comptant de tres a cinc minuts estalviats per visita.
0€
Transcripció
No hi ha cost per ús: el model corre a la infraestructura pròpia.
Aquesta xifra d'estalvi és una projecció. Saber quants minuts estalvia de veritat el sistema demana un estudi d'ús amb professionals en producció real, que queda fora de l'abast del treball i seria el primer que caldria fer en un desplegament.
On és avui
Funciona. Una altra cosa és activar-lo
El sistema està integrat a Streamly i funciona a l'entorn de preproducció. El que falta per fer-lo servir amb pacients no és tecnologia.
Hi ha dues barreres. La primera és el cost: la GPU transcriu els àudios d'un en un, així que quan molts professionals el fan servir alhora no n'hi ha prou de pagar una mica més; cal afegir un altre servidor sencer, uns 443 € més al mes cada vegada. La segona és legal: treballar amb dades de salut de pacients reals exigeix signar el contracte amb el proveïdor, fer una avaluació d'impacte i definir com es demana el consentiment.
El prototip demostra que el camí és viable. Recórrer-lo depèn de decisions d'empresa, no de codi.
I queda una pregunta sense resposta: quants minuts estalvia de veritat a cada visita. Per saber-ho cal un estudi amb professionals fent-lo servir en el seu dia a dia, i és el primer que faria abans de desplegar-lo.
Conclusions
Què m'emporto
A mesurar abans de decidir. Triar AINA per al català no va ser una intuïció: van ser vint àudios i una taula.
Que treure també és dissenyar. Presidio em va costar temps, i descartar-lo va ser una de les millors decisions del projecte.
I que en salut la IA proposa, però signa una persona. Per això tot el que genera el sistema arriba com a esborrany.
Amb què està fet
- Transcripció
- faster-whisper
small·aina-large-v3-cadel Barcelona Supercomputing Center - Model de llenguatge
- Ollama
qwen2.5:3ben desenvolupament · Azure OpenAIgpt-4.1-minien producció - Backend
- Python 3.11 · FastAPI · WebSocket · Docker
- Infraestructura
- AWS EC2
g4dn.xlargeamb Tesla T4 - Idiomes
- Català · castellà · anglès, amb detecció automàtica
- Sortides
- Transcripció · resum · diagnòstic · pla terapèutic · fitxa SOAP